第一部分:Python 数据结构
约 15124 个字 305 行代码 2 张图片 预计阅读时间 54 分钟
一、Python 数据模型
Outline of Chapter 1
1.1 数据模型和特殊方法
Python 数据模型/Data Model 是 Python 语言本身暴露出来的一组协议。解释器并不是通过“某个类继承了某个基类”来判断对象能不能被 len()、[]、for、+、with 或 await 使用,而是通过一组特殊方法/Special Method 来调用对象已经声明好的行为。特殊方法两端都有双下划线,因此也常被叫作 Dunder Method,行话有时候也叫其为魔法方法/Magic Method,例如 obj[key] 背后对应的是 obj.__getitem__(key),len(obj) 背后对应的是 obj.__len__()。
特殊方法是写给解释器调用的。我们写 len(obj)、iter(obj)、str(obj),而不是 obj.__len__()。而我们代码里唯一常见的直接调用,是在 __init__ 里用 super().__init__() 调用父类的初始化方法。很多调用还是隐式的,比如 for i in x 背后执行的是 iter(x),它先找 x.__iter__(),找不到再退回 x.__getitem__()。
通过内置函数调用还有一个好处:遇到内置类型,解释器可以走捷径。list、bytearray 这类用 C 实现的变长对象把长度存在结构体的 ob_size 字段里,len() 直接读这个字段,比调用方法快得多。这也是 len 没有做成方法的原因:取长度太常用了,必须足够快,所以 len 和 abs 一样被特殊对待,可以把它们看成一元运算符;__len__ 则让自定义对象也能用 len(),这样效率和一致性都照顾到了。
1.2 序列协议与运算符重载
一个最小的序列对象只要实现 __len__ 和 __getitem__,就能自然获得很多 Python 语言能力。下面的纸牌类用 namedtuple 表示单张牌,用一个列表保存 52 张牌:
deck = FrenchDeck() 之后,len(deck) 得到 52,deck[0]、deck[-1] 取出首尾两张牌。想随机抽一张也不用另写方法,标准库的 random.choice 对任何序列都能用。这就是遵守数据模型的好处:用这个类的人不用去猜取长度到底叫 .size() 还是 .length(),我们也能直接复用标准库,不用自己造轮子。
更多能力是顺带得到的。__getitem__ 把工作交给了 self._cards 的 [],所以切片也能用:deck[12::13] 从第 13 张开始每隔 13 张取一张,正好是四张 A。有了 __getitem__,for card in deck 和 reversed(deck) 也能工作,迭代会从 0 开始逐个按索引取值。in 在没有 __contains__ 时会顺序扫描,所以 Card("Q", "hearts") in deck 也成立。排序只需要再写一个计算排序键的函数:
FrenchDeck 只隐式继承了 object,这些能力都不是继承来的:两个特殊方法让它表现得像标准序列,组合让这两个方法把实际工作交给内部的列表。不过它现在还不能洗牌,因为除了直接去改 _cards,没有办法改变牌的位置;13.2 会给它补上 __setitem__。
数值类型也通过特殊方法接入运算符。下面的二维向量类实现了 abs()、真值判断、加法和数乘:
v1 + v2 会调用 v1.__add__(v2),v * 3 会调用 v.__mul__(3)。3 * v 就不一样了:int 的乘法不认识 Vector,左操作数不支持对应操作,于是 Python 转而调用右操作数的反向方法 v.__rmul__(3)。注意 __add__ 和 __mul__ 都返回新的 Vector,不改动任何一个操作数,中缀运算符一般都应该这样。运算符分派的完整规则见第十六章。
下面是 Python 特殊方法的列表:
Python 特殊方法
首先是不包含运算符的特殊方法:
- 字符串与字节表示:
__repr__、__str__、__format__、__bytes__、__fspath__; - 数值转换:
__bool__、__complex__、__int__、__float__、__hash__、__index__; - 容器协议:
__len__、__getitem__、__setitem__、__delitem__、__contains__; - 迭代协议:
__iter__、__aiter__、__next__、__anext__、__reversed__; - 可调用对象与协程:
__call__、__await__; - 上下文管理:
__enter__、__exit__、__aenter__、__aexit__; - 对象创建和销毁:
__new__、__init__、__del__; - 属性访问:
__getattr__、__getattribute__、__setattr__、__delattr__、__dir__; - 描述符:
__get__、__set__、__delete__、__set_name__; - 抽象基类:
__instancecheck__、__subclasscheck__; - 类元编程:
__prepare__、__init_subclass__、__class_getitem__、__mro_entries__。
下面是包含运算符的特殊方法:
- 一元运算:
__neg__(-)、__pos__(+)、__abs__(abs()); - 比较运算:
__lt__(<)、__le__(<=)、__eq__(==)、__ne__(!=)、__gt__(>)、__ge__(>=); - 算术运算:
__add__(+)、__sub__(-)、__mul__(*)、__truediv__(/)、__floordiv__(//)、__mod__(%)、__matmul__(@)、__divmod__(divmod())、__round__(round())、__pow__(**或pow()); - 反向算术运算(交换操作数):
__radd__、__rsub__、__rmul__、__rtruediv__、__rfloordiv__、__rmod__、__rmatmul__、__rdivmod__、__rpow__; - 增强赋值算术运算:
__iadd__(+=)、__isub__(-=)、__imul__(*=)、__itruediv__(/=)、__ifloordiv__(//=)、__imod__(%=)、__imatmul__(@=)、__ipow__(**=); - 位运算:
__and__(&)、__or__(|)、__xor__(^)、__lshift__(<<)、__rshift__(>>)、__invert__(~); - 反向位运算(交换操作数):
__rand__、__ror__、__rxor__、__rlshift__、__rrshift__; - 增强赋值位运算:
__iand__(&=)、__ior__(|=)、__ixor__(^=)、__ilshift__(<<=)、__irshift__(>>=)。
1.3 表示、真值和容器接口
Python 对象基本都需要一个可用的字符串表示方法,这在调试和交互时非常有用。
__repr__方法供内置函数repr()使用,获取对象的字符串表示形式,交互式控制台和调试器在表达式求值结果上就调用repr()函数。我们要求__repr__方法返回的字符串应当没有歧义,最好和重新创建这个对象的源码一样,比如Vector(3, 4);上面的Vector.__repr__用!r显示属性的repr,就是为了让Vector(1, 2)和Vector('1', '2')显示得不一样。如果没有定义__repr__方法,继承自object的__repr__方法会返回一个类似<Vector object at 0x1337beef>的字符串。__str__方法供内置函数str()使用,在背后供print()函数使用,有时候__repr__方法返回的字符串足够好,就无需定义__str__方法,因为继承自object的__str__方法最终会调用__repr__。
默认情况下,用户定义的实例都是真值,除非实现了 __bool__ 方法或者 __len__ 方法。简单来说,bool(x) 会调用 x.__bool__(),并且以 __bool__ 方法的返回值为准,如果没有实现 __bool__ 方法,则尝试调用 __len__ 方法,如果 __len__ 方法返回 0,则 bool(x) 返回 False,否则返回 True。我们要求 __bool__ 方法必须返回布尔值。
下面这张图展示了 Python 的基本容器类型的接口,图中所有的都是抽象基类:
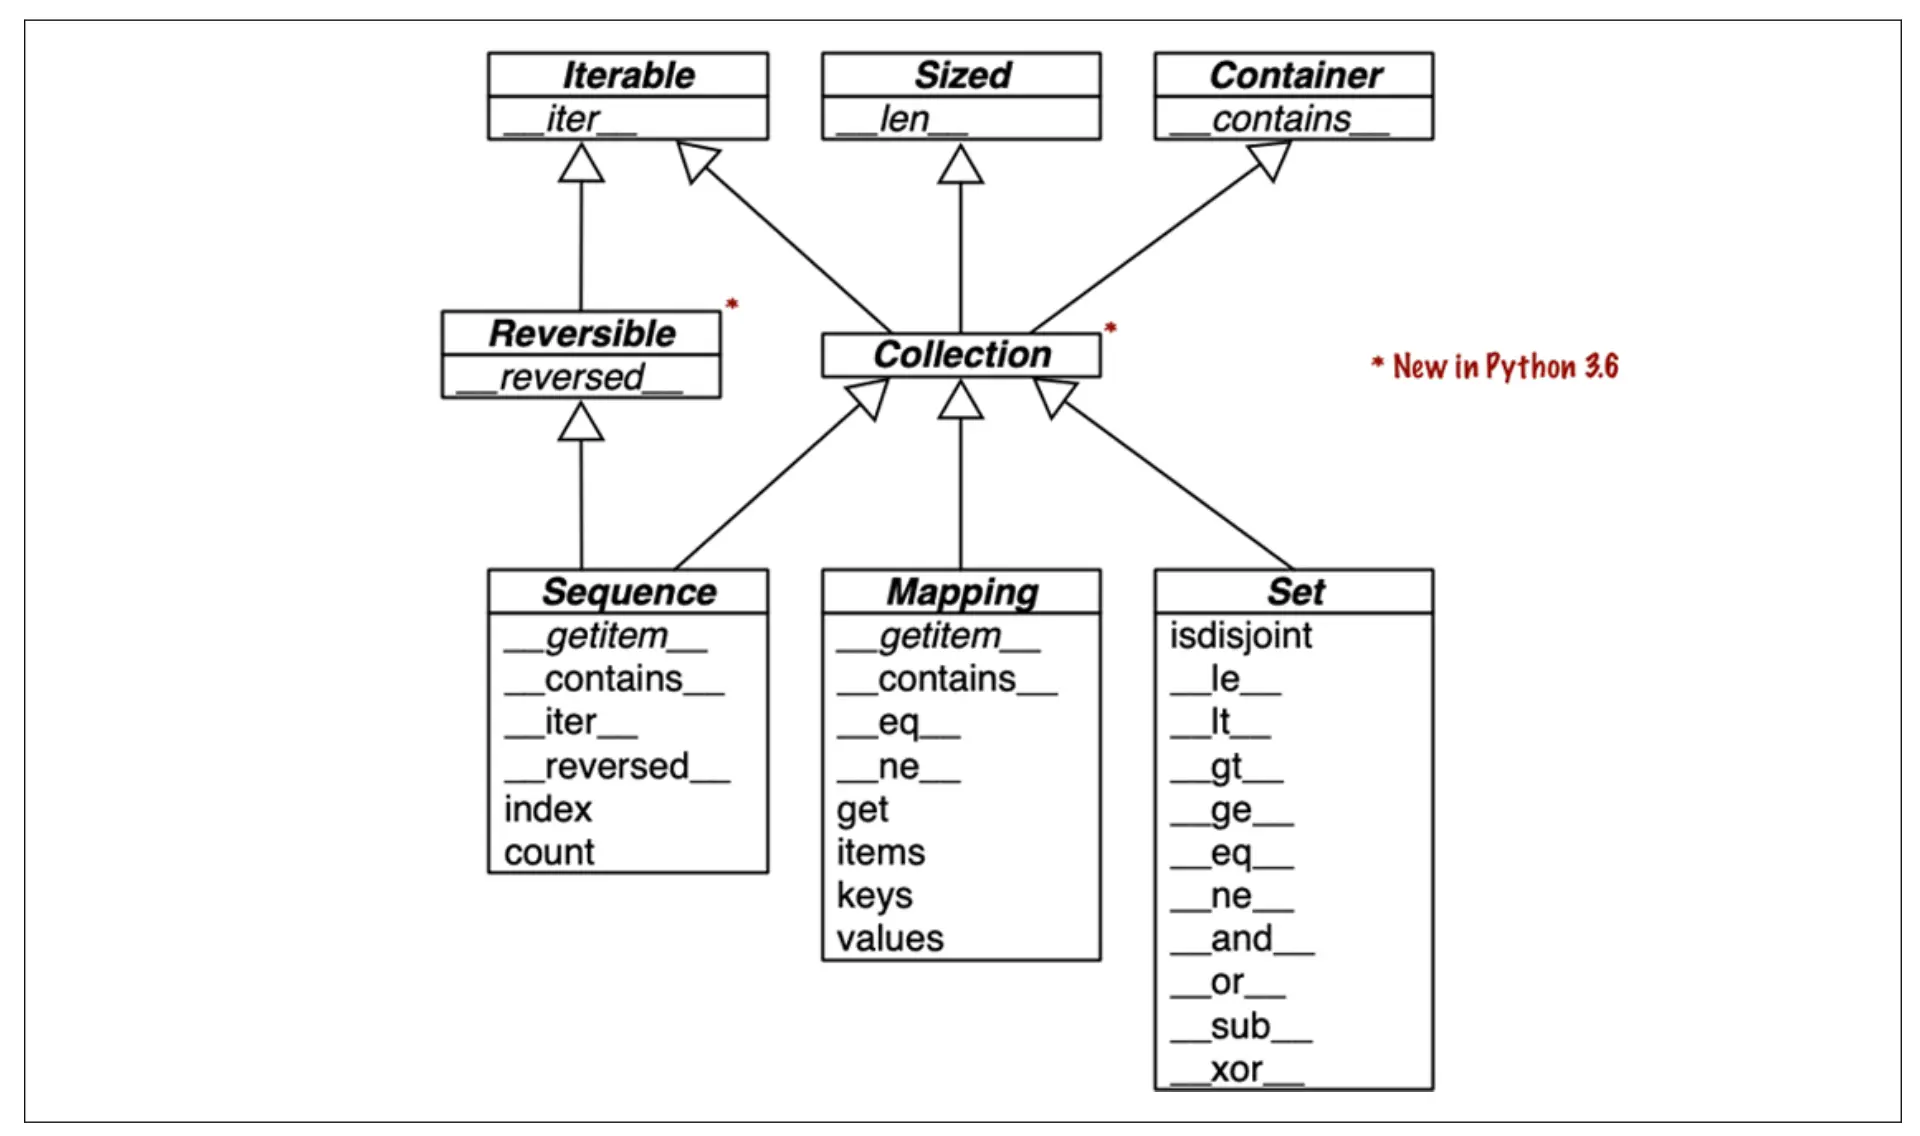
顶部三个抽象基类都只有一个特殊方法,每一个容器类型都需要实现如下事项:
Iterable要支持for、拆包和其他迭代方式;Sized要支持内置函数len();Container要支持in运算符。
Python 不强制要求具体类继承这些抽象基类中的任何一个,只需要实现对应的特殊方法,就说明对应的类满足对应接口。
Collection 有三个很重要的接口:
Sequence规范list和str等内置类型的接口;Mapping被dict、collections.defaultdict等实现;Set规范set、frozenset等内置类型的接口。
并且只有 Sequence 是 Reversible,因为序列的元素顺序可以任意安排,映射和集合则不行。dict 从 3.7 起保证插入顺序,但这只是记住插入时的先后,我们并不能随意重排它的键。
二、序列
Outline of Chapter 2
2.1 内置序列的两个维度
Python 标准库里有很多用 C 实现的序列类型,可以从两个角度给它们分类。
- 从元素如何存储来看:容器序列/Container Sequence 存的是对象的引用,所以可以放不同类型的元素,也可以嵌套别的容器,比如
list、tuple、collections.deque。扁平序列/Flat Sequence 把值本身直接存在自己的内存里,只能放字符、字节、数字这类简单的值,比如str、bytes、array.array。扁平序列要紧凑得多:Python 里每个对象都带着引用计数、类型指针这样的元数据,一个装着浮点数的tuple存的是指向一个个float对象的指针,array则直接存一串机器层面的浮点数。 - 从可变性来看:可变序列/Mutable Sequence 如
list、bytearray、array.array、deque可以原地插入、删除和替换元素;不可变序列/Immutable Sequence 如tuple、str、bytes不行,“修改”它们只会得到一个新对象,或者报错。
这两个角度互相独立:bytes 是不可变的扁平序列,bytearray 是可变的扁平序列。tuple 是不可变的容器序列,但它存的是引用,如果元组里有一个列表,列表的内容仍然可以变。后面元组的相对不可变性、+= 谜题和浅拷贝都是从这一点出发的。
2.2 列表推导式与生成器表达式
列表推导式/List Comprehension 的目标只有一件:从可迭代对象里筛选、变换元素,构造一个新列表。所以代码的意图就是生成一个列表时,用它比手写 for 循环更直接:
反过来,如果用不到生成的列表,就不该用列表推导式,写普通的 for 循环更清楚。推导式里的 for 变量有自己的局部作用域,不会覆盖外面的同名变量;例外是用海象运算符 := 赋值的变量,推导式结束后在外面仍然能访问。列表推导式也能代替 map 和 filter,而且不用写 lambda,见 7.1。
多个 for 子句可以生成笛卡尔积/Cartesian Product。子句的顺序和嵌套循环一样,写在后面的 for 变化得快:
生成器表达式/Generator Expression 和列表推导式的写法几乎一样,只是换成了圆括号。它不会一次性构造出整个列表,而是按迭代协议一个一个地产出元素。所以要构造元组、array 这类别的序列,或者结果只是交给 sum()、for 循环消费时,用它可以省下中间那个列表的内存:
生成器表达式是函数调用的唯一参数时,可以省略它自己的括号,比如 sum(x * x for x in xs);有别的参数时就得保留,比如 array.array("I", (ord(x) for x in xs))。
2.3 元组:记录与不可变序列
元组/Tuple 有两个用途。第一个是当作没有字段名的记录/Record:每个位置都有固定的含义,元素个数通常也固定,顺序不能随便改变,比如坐标 (lat, lon)、城市记录 (name, country, population)。这时最好用拆包取出字段,而不是到处写 record[0]、record[1]:
这里的 _ 只是一个普通变量名,按惯例表示这个值我们不关心。它只有在 match/case 里才是真正的通配符,见 2.4。
第二个用途是当作不可变的列表。看到元组时,我们就知道它的长度不会变,位置上的引用也不会被替换,这样代码的意图更加清晰。因为长度固定,元组比同长度列表更紧凑,更省内存,解释器也能做一些优化,更快一些。列表里不涉及增删元素的方法,元组基本都有,只少一个 __reversed__,但 reversed(t) 照样能用。
元组为什么比列表紧凑迅速
- 元组字面量编译成一个常量,一条字节码就能加载;列表字面量要把元素逐个压栈再构造列表。
tuple(t)在t已经是元组时直接返回同一个对象,不涉及复制,而list(l)总要复制一份。- 元组按实际长度分配内存,列表要预留增长空间,用来摊销后续
append的成本。 - 元组的元素引用直接存在元组结构体里的数组中;列表通过指针指向另外分配的引用数组,多一层间接访问,对 CPU 缓存也不友好。
不过元组的“不可变”只作用在元组持有的引用上,不会递归冻结被引用对象。下面两个元组一开始相等,修改 b 最后一个位置上的列表以后,元组本身的位置引用没有变化,但最后一个位置引用的列表内容变化了,所以元组的值也变了:
因此,一个元组是否可哈希,取决于它内部所有元素是否都可哈希:(1, 2, (30, 40)) 可哈希,(1, 2, [30, 40]) 不可哈希。需要快速检查一个对象的值是否固定的时候,可以调用 hash(obj),抛出 TypeError 就说明不是。
2.4 序列拆包与模式匹配
拆包/Unpacking 的核心作用是用结构表达数据,而不是用索引手动取值。并行赋值 lat, lon = coordinates、交换变量 a, b = b, a、调用函数时写 divmod(*t)、函数返回多个值,本质用的都是拆包。拆包不要求对象是序列,任何可迭代对象都行,包括不能用 [] 索引的迭代器;只要元素个数和变量个数对得上,多出来的元素可以用 * 收集。
* 可以收集多余的元素,但一个赋值目标里最多只能有一个:
PEP 448 放宽了 * 和 ** 的用法:函数调用里可以多次展开可迭代对象,列表、元组、集合的字面量里也可以直接展开:
Python 3.10 的模式匹配/Pattern Matching 把拆包推进到了声明式结构匹配:match subject 把被匹配的对象依次和每个 case 的模式比较,序列模式不但检查长度和常量,还会把对应位置的值绑定到变量上:
序列模式要求被匹配对象是序列,元素个数和嵌套结构都要对得上。模式里写方括号还是圆括号没有区别。除了变量和常量,模式里还有几种常用写法:
*rest、*_:匹配剩下任意多个元素,前者把它们绑定成列表,后者只匹配不绑定。有了它们,元素个数就不必完全一致;_:匹配任意一个元素但不绑定,也是唯一能在同一个模式里出现多次的名字;as:把一个子模式整体绑定到变量,如(lat, lon) as coord;|:几个子模式任选其一,如case ["3" | "4", *rest];ifguard:模式匹配成功之后,再做一次布尔判断。
这里的 str(name)、float(lat) 看起来像构造函数调用,实际是类模式,在运行时进行类型检查和值绑定,这里要求 name 必须是字符串,lat 和 lon 必须是浮点数,见 5.4。
但是注意,str、bytes、bytearray 在 match/case 里不作为序列处理,而是被当作原子值,否则字符串很容易被意外拆成一个个字符。若需按字符匹配,就必须先进行显式转换,比如 match tuple(phone)。
另外,模式不会像拆包那样解构序列以外的可迭代对象,被匹配的对象必须真的是序列,标准库里的 list、tuple、range、memoryview、array.array、collections.deque 都与序列模式兼容。用序列模式实现解释器的完整例子见 18.3。
2.5 切片、拼接和增强赋值
Python 切片采用左闭右开区间,s[a:b] 包含 a 位置、不包含 b 位置。这样有几个方便的地方:len(s[a:b]) 正好是 b - a;只给出终点时,s[:3] 正好是前 3 个元素;s[:x] 和 s[x:] 正好把序列切成不重叠的两段。
s[a:b:c] 的 c 是步长,可以为负,s[::-1] 就是倒序。解释器会把 [] 里的 a:b:c 变成一个 slice(a, b, c) 对象,seq[start:stop:step] 实际调用的是 seq.__getitem__(slice(start, stop, step)),见 12.2。因此可以给切片命名,让固定宽度文本的解析更清楚:
[] 还可以接收多维索引,a[i, j] 会把元组 (i, j) 传给 __getitem__。内置的序列都是一维的,只接受一个索引,NumPy 用这个语法实现多维数组的索引。省略号 ... 是内置的单例 Ellipsis,NumPy 里 x[i, ...] 表示补齐剩下的维度。
切片其实是左值,因此还可以放在赋值语句左边或者 del 后面,原地修改可变序列。给切片赋值时,右边必须是可迭代对象,哪怕只换成一个元素也要写成 [100]:
+ 和 * 总是创建新的序列,不修改操作数。用 * 初始化嵌套列表时要小心:
bad 外层列表里的三个元素引用同一个内层列表,改一行会同时改三行;列表推导式每次循环都创建一个新的内层列表,因此没有这个别名问题。
增强赋值 += 和 *= 依赖 __iadd__ 与 __imul__。如果左操作数支持原地方法,比如 list,就原地修改,对象身份通常不变;如果不支持,比如 tuple,a += b 就退化成 a = a + b,先创建一个新对象,再把 a 重新绑定过去。所以在循环里反复拼接元组这类不可变序列很慢,每次都要把整个序列复制一遍。而字符串是个例外:s += t 太常见,CPython 专门做了优化。
这个规则还解释了一个经典的边界情况:
这段代码会先把 t[2] 指向的列表原地扩展成 [30, 40, 50, 60],再试图把结果写回 t[2],因为元组不支持给元素赋值而抛出 TypeError。也就是说,修改已经发生了,异常也照样抛出。所以不要把可变对象放进元组里再做增强赋值。这个例子也说明增强赋值不是原子操作:原地扩展和写回 t[2] 是两个独立的步骤。
2.6 排序与列表替代品
list.sort() 原地排序并返回 None。这是 Python API 的惯例:会原地修改接收者的方法通常返回 None,提醒调用者没有产生新对象。sorted() 则接受任意可迭代对象,总是返回一个新列表。
两者都支持 key 和 reverse 两个可选的关键字参数。key 是一个单参数函数,为每个元素算出排序键,比如 key=len 按长度排,key=str.lower 忽略大小写排。Python 的排序算法是稳定的,排序键相等的元素保持原来的相对顺序。min()、max()、itertools.groupby()、heapq.nlargest() 这些函数也接受 key 参数。
list 很通用,但不总是最好的选择。要存大量浮点数时,array.array 存的是机器层面的数值而不是 float 对象,紧凑得多,例如 array.array("d", iterable) 创建双精度浮点数组;它还能用 .tofile() 和 .fromfile() 快速读写二进制数据。array 没有原地排序的 sort 方法,要排序只能用 sorted() 再构造一个新的 array。
memoryview 提供共享内存视图,可以在不复制字节的情况下把同一段数据解释成不同形状或不同元素类型,例如用 cast 方法转换元素类型或形状。通过 memoryview 修改数据,原对象和其他视图都会看到变化。处理图片、数组、数据库缓冲区这类大块二进制数据时它很有用。
NumPy 的 ndarray 是更强大的多维同质数组,支持向量化计算、多维切片、转置、内存映射和大量数值算法。做科学计算或者机器学习时,通常直接用 NumPy、SciPy、Pandas 这些库,而不是标准库里的容器。
collections.deque 是双端队列,适合两端频繁插入和删除。list.append() 和 list.pop() 可以把列表当栈用,但 list.pop(0) 要把后面的元素整体前移,成本很高;deque 的 appendleft()、popleft()、rotate() 都针对两端操作做了优化,代价是从中间删除元素反而不快。带 maxlen 的 deque 满了以后再加元素,会自动从另一端丢掉旧元素,适合保存“最近 N 条”这类历史窗口。append 和 popleft 是原子操作,所以多线程程序把 deque 当 FIFO 队列用也不用加锁。
标准库里的其他队列
queue:线程安全的SimpleQueue、Queue、LifoQueue、PriorityQueue,用于线程之间传数据。除SimpleQueue外都能设最大长度,但满了不会丢旧元素,而是让插入方阻塞等待,可以借此限制同时工作的线程数。multiprocessing:接口类似的SimpleQueue和Queue,用于进程之间,另有JoinableQueue管理任务。asyncio:Queue、LifoQueue、PriorityQueue,给异步任务之间协调用。这里的 API 源自queue和multiprocessing,但是为了管理异步编程任务做了修改。heapq:这个模块提供了一组函数,比如heappush、heappop,把可变序列当堆或优先队列用。
三、字典和集合
Outline of Chapter 3
3.1 现代 dict 语法
字典推导式/Dict Comprehension 把列表推导式的结构扩展到了键值对。它从任意可迭代对象中生成 key: value 对,常用于调换键值、过滤条目或构造派生映射。
映射展开使用 **。函数调用里可以多次展开映射,展开出来的键会变成关键字参数,所以键/Key 必须都是字符串,而且不能重复。字典字面量里也可以多次展开,重复的键以后出现的值为准。
Python 3.9 起,映射支持 | 和 |=,和集合的并集用的是同一个符号:d1 | d2 创建一个新映射,键重复时以右操作数为准;d1 |= d2 则原地更新左操作数 d1。
映射模式匹配看起来像字典字面量,但语义是结构匹配。和序列模式不同,映射模式允许部分匹配:被匹配对象可以有额外键,只要模式要求的键存在并且值匹配即可。
模式末尾可以用 **details 收集其余的键值对。模式匹配取值时用的是类似 d.get(key, sentinel) 的方式,所以不会触发 defaultdict 或 __missing__ 的缺失键创建逻辑,只能匹配 match 开始时已经存在的键。
3.2 可哈希与 Mapping API
可哈希/Hashable 在 Python 的术语表中有定义,其含义如下:如果一个对象的哈希值在整个生命周期内不改变,并且这个对象可以与其他对象相比较,那么这个对象就是可哈希的。两个可哈希对象如果相等,它们的哈希值也必须相等。可见,我们需要实现 __hash__ 方法和 __eq__ 方法。
- 数值类型和不可变的扁平类型
str、bytes都是可哈希的; - 如果容器类型是不可变的,并且其所含的对象都是可哈希的,那么容器自身是可哈希的。
所以:
frozenset总是可哈希的,因为它的元素按定义必须可哈希;tuple只有在所有元素都可哈希时才可哈希;- 用户定义的类型默认可哈希,因为默认的哈希值来自
id(),从object继承的__eq__也只比较id。如果自己写的__eq__要比较对象内部的状态,那么只有__hash__总是返回同一个值时它才可哈希,实际上这要求__eq__和__hash__只用对象生命周期内不会变的属性。
一个对象的哈希值与所使用的 Python 版本和设备架构有关,哈希计算过程中也有加盐操作,正确实现的对象,其哈希值只在一个进程内保持不变。所以不要把哈希值存下来,或者拿到别的进程里比较。
collections.abc 里的 Mapping 和 MutableMapping 描述了映射接口。写需要接收通用映射的代码时,用 isinstance(x, abc.Mapping) 比 type(x) is dict 更合适,因为这样可以兼容 defaultdict、OrderedDict、用户自定义映射等类型。
dict.update() 是鸭子类型/Duck Typing 的一个例子:它不检查参数的类型,参数有 .keys() 方法,就将其当作映射,否则当作产出 (key, value) 对的可迭代对象。大多数映射构造函数内部也复用类似逻辑,因此可以从另一个映射、键值对迭代器或关键字参数初始化。
当字典的值是可变对象并且需要“取出后更新”时,用 setdefault() 可以避免重复查找:
这等价于“如果 word 不存在就创建空列表,再把位置加入列表”,但只做一次键查找。这其实就引出了一个相关话题:如何自动处理缺失的键。
3.3 缺失键的自动处理
有时候我们访问的键并不一定存在,这时可以让映射返回一个预先设定的值,以方便处理。实现这一点一般有两种方法:一种是将普通的 dict 换成 collections.defaultdict,另一种是定义 dict 或其他映射类型的子类,实现 __missing__ 方法。
defaultdict(list) 把上面的模式封装进映射对象本身:index[word].append(location) 遇到不存在的键,会先调用 list() 创建默认值,再插入并返回它的引用。
但是注意,构造时传入的 default_factory 仅为 __getitem__ 方法提供默认值,只在 dd[k] 这种写法里起作用,对不存在的 k,dd.get(k) 还是返回 None,k in dd 还是 False。
defaultdict 背后的机制是 __missing__。dict 基类本身不定义这个方法,但 dict.__getitem__ 知道它:如果 dict 的子类提供了 __missing__,那么 dict.__getitem__ 在找不到键时就调用它,而不是抛出 KeyError。
下面的映射在查找非字符串键失败时,会把键转成字符串再查一次,适合让 pins[13] 和 pins["13"] 都能找到同一个引脚:
isinstance(key, str) 这个检查不能省:如果 str(k) 也不是已有的键,self[str(key)] 会再次进入 __getitem__、再次触发 __missing__,无限递归下去。
另外两个方法也要自己写,因为 dict 继承来的 get 和 __contains__ 都不会去调用 __missing__。
get用self[key]把查找交给__getitem__,__missing__就有机会处理。__contains__在self.keys()上查而不是写key in self,否则str(key) in self又会递归调用__contains__;先查原始键是因为StrKeyDict0并不保证所有键都是字符串。
一个 __missing__ 会影响哪些操作,取决于基类的其他方法会不会调用它,不同的映射基类在这点上并不一致。
__missing__ 在不同基类中的表现
下面四种情况都只实现最少的方法:
dict的子类只实现__missing__:只有d[k]会触发它,因为只有继承来的dict.__getitem__调用它。collections.UserDict的子类只实现__missing__:d[k]和d.get(k)都会触发它,因为UserDict.get会调用__getitem__。abc.Mapping的子类,仅实现__missing__方法和必要的抽象方法:__getitem__不调用__missing__,__missing__永远不会被触发。abc.Mapping的子类,令__getitem__调用__missing__:d[k]、d.get(k)和k in d都会触发它。
子类如果自己实现了 __getitem__、get 和 __contains__,就可以自行决定用不用 __missing__。setdefault 和 update 也依赖键查找,必要时还要在 __setitem__ 里加配套逻辑,避免前后行为不一致。
因此,创建自定义映射时,继承 collections.UserDict 比直接继承 dict 更合适。内置 dict 的实现有一些捷径,会迫使我们重写本可以直接继承的方法,见 14.2。UserDict 并不继承 dict,而是通过组合在内部持有一个名为 data 的字典,因此实现 __setitem__ 这类特殊方法时不会意外递归,__contains__ 也更简单:
StrKeyDict 在插入时就把所有键转换成字符串,所以 __contains__ 直接在 self.data 上查找即可。其余方法都继承自 UserDict 和 abc.MutableMapping。其中 update 用 self[key] = value 逐个添加元素,构造函数也会调用它,因此用其他映射或键值对初始化时,键同样会经过 __setitem__ 转换成字符串。
3.4 dict 的实现后果与变体
Python 的 dict 基于哈希表实现,因此键必须可哈希,按键访问非常快,即使字典有大量条目也能通过哈希值定位候选槽位。代价是内存开销明显高于元组这类只存指针数组的紧凑容器,因为哈希表需要保存额外元数据,并至少保留三分之一的空槽来维持效率。
这一点也影响普通对象的内存。实例属性默认存在每个实例的 __dict__ 中,CPython 通过键共享字典(PEP 412)让同一个类的实例共用一张属性名表,前提是各实例在 __init__ 结束时拥有相同的属性名。在 __init__ 之外新增属性会破坏共享,因此要节省内存,应在 __init__ 中创建全部实例属性。
CPython 3.6 的紧凑字典实现让插入顺序保留变成自然结果,Python 3.7 起这成为语言保证。因此普通 dict 已经保持插入顺序,但 OrderedDict 仍有用途:它的相等性比较会考虑顺序,popitem() 可以通过 last 参数选择弹出头部或尾部,move_to_end() 可以高效移动键的位置,适合 LRU 缓存这类频繁重排的场景。
collections.ChainMap 把多个映射按顺序串成一个查询视图,查找时从第一个映射开始,找到即返回。ChainMap 不复制输入映射,而是只保存映射引用;写入、更新和删除默认只作用在第一个映射。这个模型很适合解释器里的嵌套作用域,例如 ChainMap(locals(), globals(), vars(builtins))。
collections.Counter 是键到整数计数的映射,适合统计可哈希对象的实例数量,也可以当多重集合使用。.update() 会累加计数,.most_common(n) 返回出现次数最高的条目,+ 和 - 可以合并或相减两个计数器。
shelve 模块提供持久化的映射:shelve.open() 返回一个 shelve.Shelf 实例,这是一个由 dbm 支持的简单键值数据库,键必须是字符串,值通过 pickle 序列化保存。Shelf 是 collections.abc.MutableMapping 的子类,因此提供映射类型的基本方法,此外还有 sync()、close() 等 I/O 管理方法;它也是上下文管理器,可以用 with 块保证用完后关闭。每次给键赋新值时,键和值就会被保存。使用时要把 pickle 的安全和兼容性限制考虑进去。
标准库没有真正不可变的映射类型,但 types.MappingProxyType 可以给已有映射创建只读动态代理。代理不能被写入,但原始映射更新后,代理能看到变化。它适合把内部配置或硬件引脚表这类结构暴露给用户,同时防止外部代码误改。
dict.keys()、dict.values()、dict.items() 分别返回 dict_keys、dict_values、dict_items 的实例。它们是字典内部数据结构的只读动态视图/View。视图会反映原字典的后续变化,所有视图都支持 len()、迭代和 reversed(),但不能按索引访问。这三个类是内部类,无法通过 __builtins__ 或标准库中的任何模块获取;即使通过 type() 拿到类对象,也不能在 Python 代码里直接创建实例。以 dict_values 为例:
dict_values 是最简单的字典视图,只实现了 __len__、__iter__ 和 __reversed__,不支持集合运算。dict_keys 和 dict_items 在此之外还实现了和 frozenset 相近的集合方法,支持 &、|、-、^ 运算,结果是 set,另一个操作数也可以是普通集合。例如 d1.keys() & d2.keys() 可以直接求两个字典的公共键,d1.keys() | s 则和集合 s 求并集。dict_keys 总能当作集合使用,因为键一定可哈希;dict_items 只有在值也都可哈希时才能作为集合参与运算,否则抛出 TypeError。
3.5 set 与 frozenset
集合/Set 是唯一元素的无序集合,最直接、最基本的用途是去重和快速成员测试。set 可变,frozenset 不可变。集合元素必须可哈希,而 set 本身不可哈希,因此 set 不能包含 set,但可以包含 frozenset。
集合实现了数学集合运算:a | b 是并集,a & b 是交集,a - b 是差集,a ^ b 是对称差集。合理使用集合运算可以替代很多显式循环和条件判断,例如统计 needles 中有多少元素出现在 haystack 中,可以写成 len(needles & haystack)。
中缀运算符要求两侧都是集合,对应的方法则接受任意可迭代对象:a.union(b, c, d) 只要求 a 是集合,b、c、d 是产出可哈希元素的可迭代对象即可。因此当 needles 和 haystack 不一定是集合时,可以写成 len(set(needles).intersection(haystack))。&=、difference_update() 这类原地修改的运算只有 set 支持,frozenset 没有:frozenset 不可变,没有 __iand__ 这类原地方法,因此和 2.5 里的元组一样,对它做增强赋值 fs &= x 会退化成 fs = fs & x,得到一个新对象。
空集合必须写成 set(),因为 {} 是空字典。非空集合字面量如 {1, 2, 3} 比 set([1, 2, 3]) 更直接,也更快:后者要先查找 set 这个名字、构造一个列表,再把列表传给构造函数。frozenset 没有字面量语法,只能调用构造函数。
集合推导式/Set Comprehension 与列表推导式类似,但结果自动去重:
由于 set 和 frozenset 都基于哈希表,成员测试非常快,内存开销也明显高。元素顺序和插入顺序有关,但并不可靠:哈希冲突和表扩容都会影响迭代顺序,添加新元素甚至可能改变已有元素的顺序。
四、Unicode 文本和字节序列
Outline of Chapter 4
4.1 str 与 bytes
Python 3 把文本和二进制数据明确分开:str 是 Unicode 码位/Code Point 的序列,bytes 和 bytearray 是 0 到 255 的整数序列。码位是字符的标识,即 0 到 1,114,111 之间的一个整数,在 Unicode 标准里写成 U+ 加 4 到 6 位十六进制数。编码/Encoding 是把码位转换成字节序列,解码/Decoding 是把字节序列转换回码位:
同一个字符的码位是稳定的,但它在文件或网络中的字节表示取决于编码。例如 "é" 的码位是 U+00E9,在 UTF-8 中占两个字节,在 Latin-1 中占一个字节,在 ASCII 中则无法表示。
bytes 不等于旧版 Python 2 的 str。它的每个元素是整数而不是单字符字符串,切片则总是返回同类型的二进制序列,因此 b[0] 返回 int,b[:1] 返回长度为 1 的 bytes。这和其他序列类型一致:单个元素和长度为 1 的切片不是同一类东西。只有 str 例外,它是唯一满足 s[0] == s[:1] 的序列类型。bytearray 是可变版本,没有字面量语法,通常用 bytearray(b"...") 创建。
二进制序列中经常嵌有 ASCII 文本,所以它的显示形式偏向 ASCII:可打印 ASCII 字节直接显示为字符,制表、换行等使用转义序列,其他值使用 \x 加两位十六进制数的转义。因此 b"caf\xc3\xa9" 的前三个字节是可打印的 caf,后两个字节是 "é" 的 UTF-8 编码。
除了格式化方法(format、format_map)和依赖 Unicode 数据的方法(如 casefold、isdecimal、isnumeric、encode),str 的方法 bytes 和 bytearray 都支持,例如 endswith、replace、strip、upper,只是参数要换成 bytes。二进制序列还有一个 str 没有的类方法 fromhex,bytes.fromhex("31 4B CE A9") 可以从十六进制文本构造字节序列。其他构造方式包括:传入 str 并指定 encoding,传入产生 0 到 255 整数的可迭代对象,或传入支持缓冲协议/Buffer Protocol 的对象,例如已有的 bytes、bytearray、memoryview、array.array。
4.2 编码/解码错误和文本文件边界
编码时,如果目标编码无法表示某个字符,会抛出 UnicodeEncodeError。UTF 系列编码能表示所有 Unicode 码位,而很多旧编码只覆盖很小的字符集。encode 的 errors 参数可以改变错误处理方式:'ignore' 丢弃无法表示的字符,'replace' 用 ? 替代,'xmlcharrefreplace' 用 XML 字符引用保存信息。'ignore' 会悄无声息地丢失数据,除非明确接受数据损失,否则不要使用。
解码时,如果字节序列不是目标编码下的合法字节流,会抛出 UnicodeDecodeError;用 errors='replace' 解码时,非法字节会被替换成替换字符 U+FFFD。更危险的是,cp1252、koi8_r 这类 8 位旧编码几乎可以解码任意字节,即使编码猜错也不会报错,只会得到乱码。因此,编码不是可以从字节本身可靠推出的信息,最好由协议、文件格式或元数据明确提供。没有元数据时,只能依靠 Chardet 这类工具根据统计规律做启发式猜测。
Python 3 源码默认使用 UTF-8。如果 .py 文件实际是其他编码,又没有编码声明,加载模块时会抛出 SyntaxError。可以在文件开头加上 # coding: cp1252 这样的编码声明,但更好的做法是把源码转成 UTF-8。
字节序标记/Byte Order Mark/BOM 主要出现在 UTF-16 和 UTF-32 中,用于标明字节序:使用 utf-16 编码时会在开头写入 BOM,utf-16le、utf-16be 则不写。UTF-8 不需要 BOM,但部分 Windows 程序仍会写入。读取这类文件时使用 utf-8-sig 编码,无论有没有 BOM 都能正确处理;写普通的跨平台文本时,直接使用 utf-8 即可。
处理文本 I/O 的基本原则是 Unicode 三明治/Unicode Sandwich:输入时尽早把 bytes 解码成 str,程序内部只处理 str,输出时尽量晚地把 str 编码成 bytes。文本模式的 open() 会自动完成编码和解码,但应当显式传入 encoding:
不传 encoding 时,默认编码取决于平台和区域设置。GNU/Linux 和 macOS 现在大多默认使用 UTF-8,而 Windows 上文件、控制台、文件系统和重定向后的标准流可能各自使用不同的编码,同一段代码换一台机器就可能读出乱码。Python 3.15 起默认开启 UTF-8 模式(PEP 686),open() 不传 encoding 时也使用 UTF-8;但代码需要在更早的版本上运行时,仍然应该显式传入。
4.3 规范化、大小写折叠与排序
Unicode 允许同一个人类可见的字符有多种码位表示。例如 "é" 可以是单个码位 U+00E9,也可以是 "e" 加上组合用的尖音符 U+0301。二者在 Unicode 中是规范等价的,但 Python 直接比较时认为它们不相等,因此可靠的比较之前需要先做规范化/Normalization。
unicodedata.normalize() 支持四种规范化形式:NFC、NFD、NFKC、NFKD。NFC 把组合序列合成最短的等价形式,NFD 则相反,把字符分解成基字符加组合符号。W3C 建议用 NFC 存储和比较文本,键盘输入的文本通常也已经是 NFC。NFKC 和 NFKD 中的 K 表示兼容性/Compatibility,它们还会把兼容字符替换成“首选”形式,例如把 "½" 变成 "1⁄2",把上标的 "4²" 变成 "42"。这会丢失信息,因此只适合在搜索和索引中作为中间表示,不能用于永久保存文本。
大小写折叠/Case Folding 把文本统一转换成可以忽略大小写比较的形式。应该使用 str.casefold() 而不是 str.lower(),因为 casefold() 会处理更多语言特例,例如德语的 ß 会被折叠成 "ss"。实用的比较函数通常先做 NFC 规范化,再做大小写折叠:
去掉变音符号,例如把 "café" 变成 "cafe",并不是 Unicode 标准的规范化,而是面向搜索、URL 和索引的更激进转换。它可以先用 NFD 分解,再滤掉组合符号来实现,但会改变一些词的含义,甚至造成误匹配,因此只在明确目标语言和用途时才这样做。
字符串默认按码位排序,这不符合大多数自然语言的排序习惯。标准库的方案是先用 locale.setlocale() 设置合适的区域,再把 locale.strxfrm 作为排序的 key;但区域设置是进程全局的,可用的区域还取决于操作系统。更可靠的方案是第三方库:pyuca 实现了 Unicode 排序算法/Unicode Collation Algorithm,PyICU 则可以按不同语言的习惯排序,而且不会修改进程的区域设置。
4.4 Unicode 数据库与 dual-mode API
Unicode 标准包含一个字符数据库,记录了每个码位的名称、类别、数值等信息,Python 的 unicodedata 模块可以查询它:unicodedata.name("A") 返回 'LATIN CAPITAL LETTER A',unicodedata.numeric("½") 返回 0.5。str 的 isalpha()、isdecimal()、isnumeric()、casefold() 等方法也依赖这些数据。按名字查找字符时,可以遍历码位,检查 name() 的结果中是否包含要找的单词。
标准库中有些 API 同时接受 str 和 bytes,但两种模式的行为不同,这类 API 称为双模式 API/Dual-Mode API。re 模块是典型的例子:用 str 编译的正则表达式中,\d、\w 能匹配 Unicode 数字和单词字符;用 bytes 编译的正则表达式只按 ASCII 语义匹配字节。
os 模块也有这种双模式行为。传入 str 路径时,Python 用文件系统编码与操作系统交互,返回的也是 str;传入 bytes 路径时,返回的结果也是 bytes。一般代码使用 str 路径即可,只有在处理无法正常解码的文件名时才使用 bytes,并配合 os.fsencode()、os.fsdecode() 在两者之间转换。
五、数据类构建器
Outline of Chapter 5
Python 提供了几种构建简单类的方式,这些类只是字段的容器,几乎没有额外功能,这些模式被称为数据类/Data Class,dataclasses 包就支持该模式。这一节介绍 collections.namedtuple、typing.NamedTuple 和 @dataclasses.dataclass。
5.1 三种构建器
例子
可以看见,这个类的实现比较简单但是失败:
- 没有
__repr__方法,从object继承的__repr__方法返回的字符串没有信息量; - 没有
__eq__方法,从object继承的__eq__方法比较的是对象的地址/ID,而不是lat和lon的值; - 想要对比两个坐标是否相等,需要手动对比
lat和lon的值。
typing.NamedTuple 也可以写成 class 语句,类型注释按照 PEP 526 标准编写,这样的代码更易读。值得注意的是,虽然 typing.NamedTuple 位于超类的位置上,但是实际上 typing.NamedTuple 使用元类构建用户类。typing.NamedTuple 生成的 __init__ 方法中,字段参数的顺序与在 class 中出现的顺序相同。
collections.namedtuple 是一个工厂函数,返回 tuple 的子类。字段名保存在类上而不是实例上,因此实例占用的内存和普通元组相同。除了按字段名访问和可读的 repr,它还提供几个工具:_fields 是字段名组成的元组,_make(iterable) 从可迭代对象构造实例,_asdict() 把实例转换成 dict,_replace(**kwargs) 替换部分字段并返回新实例。构造类时还可以用 defaults 参数为最右边的几个字段设置默认值。
typing.NamedTuple 构造的也是 tuple 的子类,并为每个字段加上类型注解。除了多一个 __annotations__ 类属性,它生成的类和 namedtuple 生成的类没有区别。类语句的写法可读性更好,也更容易添加方法和文档字符串。
@dataclass 是类装饰器,不改变类的继承层次。它支持字段级的配置,并提供 dataclasses.asdict()、fields()、replace()、make_dataclass() 等函数。默认生成的实例是可变的,设置 frozen=True 可以防止意外修改。不过这只是模拟不可变:生成的 __setattr__ 和 __delattr__ 在修改字段时抛出 FrozenInstanceError,实例并不是真正不可变的。
三种数据类构建器的共同点和差异如下:
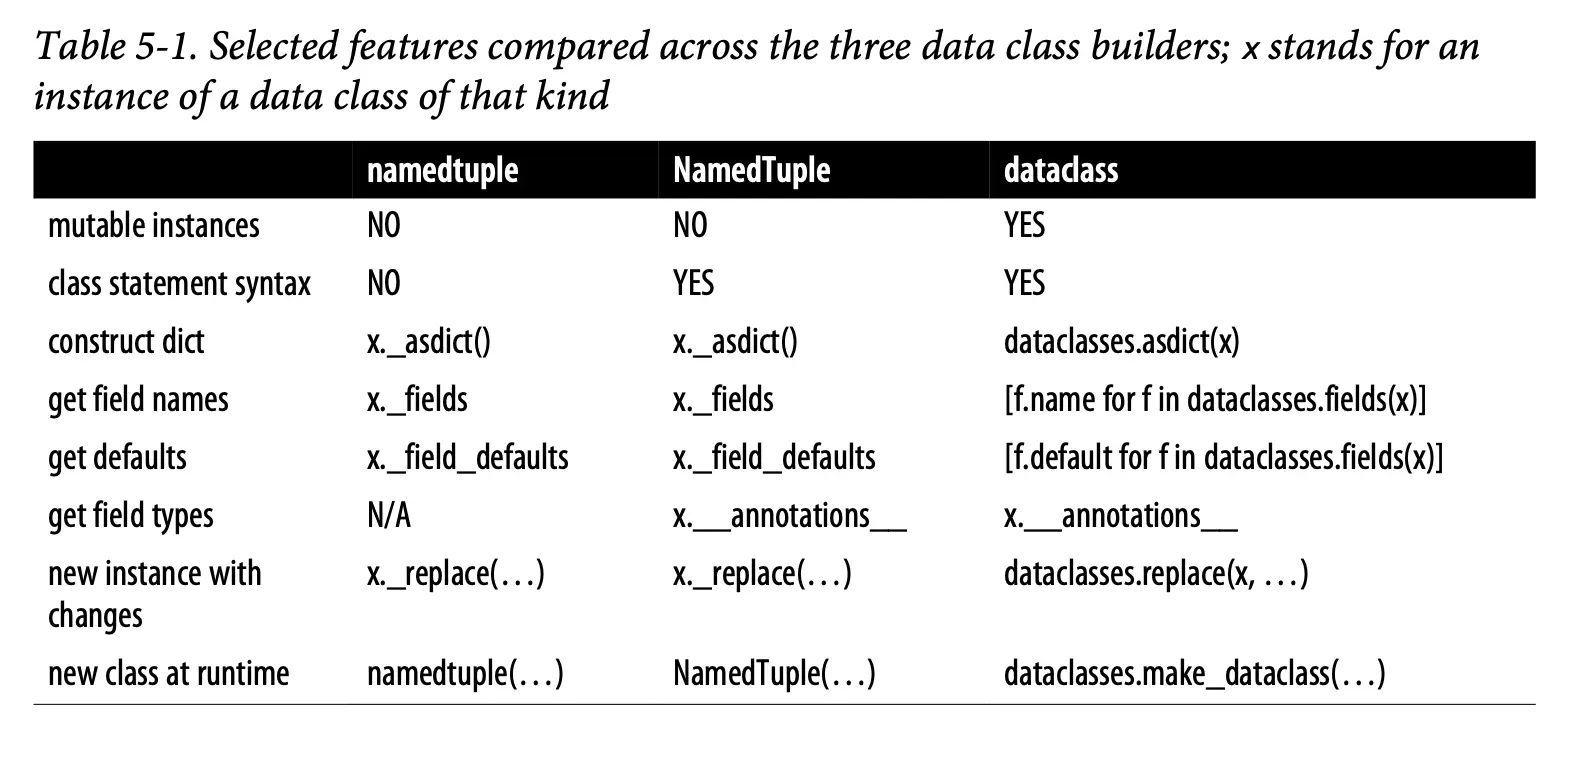
前两者构造的是元组的子类,实例不可变,也可以当作元组使用;@dataclass 生成的是普通的类,实例默认可变,也可以继承别的类。
5.2 类型提示的运行时语义
类型提示/Type Hint 是供 IDE、Mypy 等工具检查的文档,Python 解释器在运行时并不强制执行。下面的代码虽然把字段声明为 float,运行时仍能创建出字段类型完全错误的对象,这类错误只能由静态检查工具发现:
变量注解的基本形式是 var_name: some_type,也可以带默认值 var_name: some_type = a_value。在普通类、NamedTuple 和 @dataclass 中,类体里的注解都会收集到类的 __annotations__ 中,后两者还会读取它来生成字段。三者的区别在于类体中的 a: int、b: float = 1.1 和未注解的 c = 'spam' 最终分别变成什么:
- 普通类:
a只出现在__annotations__中,不会成为类属性;b既在__annotations__中,也是值为1.1的类属性;c只是普通的类属性。实例不会因为注解获得任何属性; NamedTuple:a和b都成为实例的只读字段,在类上表现为描述符,b的默认值使它成为构造函数的可选参数;c仍是普通的类属性,不是字段;@dataclass:a和b都成为可读写的实例字段,也都是生成的__init__的参数,b的默认值1.1同时也是类属性;c仍是普通的类属性。
@dataclass 同样不根据注解做运行时类型检查,它只把注解当作字段声明。
5.3 @dataclass 的字段选项
@dataclass 接受几个关键字参数:init、repr、eq、order、unsafe_hash、frozen。默认值适合大多数场景:生成 __init__、__repr__ 和 __eq__,不生成排序方法,实例可变。最常修改的是 frozen=True,以及生成 <、> 等比较方法的 order=True。
__hash__ 的生成规则如下:eq 和 frozen 都为真时,自动生成合适的 __hash__;eq 为真而实例可变时,__hash__ 被设为 None,实例不可哈希,因为可变对象作为字典的键会破坏哈希表。unsafe_hash=True 可以强制生成 __hash__,只有在确定不会修改实例时才应使用。
字段默认值要特别小心。@dataclass 不允许把 list、dict、set 这类可变对象直接作为默认值,否则所有实例会共享同一个对象,类定义时就会抛出 ValueError。3.11 起判断标准改为是否可哈希,因此不可哈希的自定义对象也不能直接作为默认值。正确的写法是 field(default_factory=list),每创建一个实例就调用一次工厂函数,生成新的列表。
field() 的其他参数控制该字段是否出现在 __init__、__repr__、比较方法和哈希计算中,metadata 参数可以附带任意用户数据。字段顺序遵守函数参数的规则:一个字段有了默认值,它后面的字段也都必须有默认值。
生成的 __init__ 执行完毕后,如果类定义了 __post_init__,就会调用它。它适合用来校验字段,或者根据其他字段计算新的字段。下面的 HackerClubMember 在没有给出 handle 时使用名字的第一个词,并保证 handle 不重复:
all_handles 是所有实例共享的类属性。ClassVar 是给类型检查器和 @dataclass 看的伪类型,表示这个名字是类属性而不是实例字段;如果不这样标注,@dataclass 会把它当作字段,并因为默认值 set() 是可变对象而报错。InitVar 则表示只在初始化时使用的参数:它会出现在生成的 __init__ 中并传给 __post_init__,但不会成为实例字段,也不会出现在 dataclasses.fields() 的结果中。例如 database: InitVar[DatabaseType] = None 就是一个只在构造时用来查询数据的参数。
5.4 数据类的设计边界和类模式匹配
数据类很方便,但一个只有字段、没有行为的类,也可能是设计上的坏味道/Code Smell。面向对象的基本目标是把数据和操作这些数据的行为放在同一个类里。如果一个类只有字段,而用到这些字段的逻辑散落在其他地方,就应该考虑把这些行为移回类中。
数据类比较适合两种场景。第一种是脚手架:项目初期先用数据类确定字段,之后再逐渐加入方法;等类有了自己的行为,它也就不再只是数据类了。第二种是中间表示:从 JSON 等外部格式读入,或者准备导出的记录。此时最好把实例当作不可变的值处理,即使它在技术上可以修改。
模式匹配也可以匹配类实例。像 float(x) 这样的简单类模式只对一组内置类型有效:bool、bytearray、bytes、dict、float、frozenset、int、list、set、str、tuple。匹配时先检查类型,再把被匹配的值绑定到 x,前面序列模式中的 str(name) 就是这样。对其他类来说,括号里看起来像构造参数的部分,其实是与实例属性匹配的子模式。普通类常用关键字类模式,按公开的属性名匹配:
位置类模式更简短,但要依靠类属性 __match_args__ 声明位置与属性的对应关系,NamedTuple 和 @dataclass 会自动生成它。因此对这两种类可以写:
位置模式依赖 __match_args__ 中字段的顺序,字段顺序一旦改变,模式的含义也随之改变;关键字模式没有这个问题。
六、对象引用、可变性和回收
Outline of Chapter 6
6.1 名称绑定、身份和值
Python 的变量是贴在对象上的标签,而不是装着对象的盒子。执行 b = a 不会复制 a 指向的对象,而是让名称 b 也绑定到同一个对象上:
赋值语句总是先求值右侧,创建或取得对象,然后再把左侧的名称绑定到它。因此,与其说“把对象赋给变量”,不如说“把变量绑定到对象上”。
每个对象都有身份/Identity、类型/Type 和值/Value。身份在对象创建后就不再改变,可以理解为对象在内存中的地址:id(obj) 返回表示身份的整数(在 CPython 中就是内存地址),is 运算符比较的就是身份。== 比较的是值,实际调用 __eq__。两个变量可以是同一个对象的别名/Alias,也可以绑定到值相等但身份不同的两个对象:
a == b 是 a.__eq__(b) 的语法糖,可以被重载;is 不能重载,所以比 == 快。日常代码更关心值是否相等,因此 == 更常用。is 适合与单例比较,最常见的是 x is None 和 x is not None,也可以用来和自己创建的哨兵对象比较,例如 END_OF_DATA = object()。
6.2 相对不可变与浅拷贝
元组的不可变性是相对的:元组内部保存的引用不可变,但引用指向的对象可以改变。这解释了为什么 2.3 中 (10, "alpha", [1, 2]) 的列表被修改以后,整个元组的值也跟着改变。
复制默认是浅的。浅拷贝/Shallow Copy 只复制最外层的容器,内部元素仍然是同一批对象的引用,list(l1) 和 l1[:] 都是浅拷贝。如果内部元素都是不可变对象,浅拷贝通常没有问题;如果内部有列表这样的可变对象,两个外层容器就会共享这些内部对象:
copy.copy(obj) 也是浅拷贝。copy.deepcopy(obj) 做的是深拷贝/Deep Copy:递归复制内部对象,副本和原对象不再共享任何内部的可变对象,循环引用也能正确处理。深拷贝并不总是合适的,因为有些对象引用了不应被复制的外部资源或单例。需要控制复制行为时,可以实现 __copy__ 和 __deepcopy__ 特殊方法。
6.3 共享调用与可变参数
Python 的参数传递方式是共享调用/Call by Sharing:函数的每个形参得到的是实参引用的一份副本,也就是说,形参成为实参的别名。因此函数可以修改传入的可变对象,但无法让调用方的变量绑定到另一个对象:
不要用可变对象作为参数的默认值。默认值在定义函数时求值,且只求值一次,随后保存在函数对象的 __defaults__ 属性中;如果默认值是一个列表并被函数原地修改,之后每次省略该参数的调用都会共享这个被修改过的列表。下面的 BadBus 在没有乘客时会共享同一个列表,一辆车上的乘客会出现在另一辆车上:
正确的做法是用 None 作为默认值,在函数体内创建新对象:
这里的 list(passengers) 也是一种防御性复制/Defensive Copy。如果直接写 self.passengers = passengers,乘客下车时,调用方传入的列表也会被修改。除非函数的目的就是修改传入的对象,否则在把可变参数保存为实例属性之前,最好先复制一份。复制还带来一个好处:参数可以是元组、集合等任意可迭代对象。
6.4 del、垃圾回收和 CPython 优化
del 是语句而不是函数,它删除的是名称(或者容器中的引用),而不是对象。只有当对象没有任何引用、变得不可达之后,它才可能被垃圾回收。下面的 del a 不影响列表对象,因为 b 仍然引用它;直到 b 被重新绑定,原来的列表才变得不可达:
CPython 主要使用引用计数/Reference Counting:每个对象记录有多少引用指向自己,引用数归零时对象立即被释放;此外还有一个分代垃圾回收器,用于处理循环引用。其他 Python 实现不一定立即回收对象,因此不要依赖“这一行之后对象就被销毁”这种 CPython 细节。文件、锁、网络连接等外部资源应该用 with 语句或显式关闭来管理,而不是依赖 __del__。
weakref.finalize(obj, callback) 可以注册一个在对象被回收时调用的回调。它使用弱引用/Weak Reference,也就是不增加引用计数的引用,因此不会因为监视对象而延长其生命周期。弱引用更常见的用途是缓存:缓存需要引用对象,但不应该仅仅因为缓存还引用着它,就让它一直无法被回收。
CPython 对不可变对象还有一些优化:t 是元组时,tuple(t) 和 t[:] 直接返回 t 本身,不做复制;一些字符串字面量和小整数会被驻留/Interning,多个变量共享同一个对象。这些都是实现细节,不能作为程序逻辑的依据。比较值用 ==,比较单例才用 is。